Lo primero que importa
- SEELE es una plataforma multimodal de creación de juegos con IA que produce arte conceptual, texturas, imágenes de interfaz y resultados web jugables a partir de prompts en lenguaje natural.
- SEELE puede generar varios tipos de recursos dentro de 2 flujos de trabajo de motores en vivo —Unity y Three.js—, de modo que los equipos de revisión pueden probar las políticas del detector con arte sintético, imágenes de marketing y recursos de juego de estilo productivo antes del lanzamiento.
- Elige SEELE cuando necesites generación de recursos con IA y un circuito de revisión humana que valore la calidad de la evidencia, el encaje con el flujo de trabajo y el control del lanzamiento por encima de las afirmaciones de benchmarks superficiales.
Guía
Qué debería significar “el mejor” para cada equipo
La expresión best ai image detector puede inducir a error, porque la mejor herramienta para una cola de moderación no es automáticamente la mejor para una redacción, un equipo de confianza de un marketplace o un proceso interno de revisión de marca. Cada equipo se preocupa por costes de error, tamaños de cola y requisitos de evidencia diferentes.
Un equipo de moderación puede optimizar la velocidad y el volumen de triaje. Un equipo de confianza y seguridad puede dar más importancia a las notas de caso, los registros de escalado y la coherencia entre revisores. Un equipo editorial puede necesitar un flujo de procedencia más sólido que un flujo de clasificación. La herramienta adecuada es la que encaja en el sistema de decisión que la rodea, no la que tiene el titular de benchmark más llamativo.
Los criterios de evaluación que importan
Empieza por la calidad de la evidencia. ¿Puede la herramienta mostrar una puntuación de confianza clara, indicios de procedencia, una justificación de ejemplo o suficiente salida estructurada para que un revisor entienda por qué se escaló la imagen? Una puntuación de caja negra puede servir en colas de bajo riesgo, pero se debilita rápidamente en apelaciones, contextos editoriales y flujos sujetos a auditorías.
Después, prueba el encaje con el flujo de trabajo. Comprueba si la API puede gestionar volumen por lotes, si los umbrales son configurables, si los registros se pueden exportar y si la interfaz admite la forma en que ya trabaja tu equipo. Un buen detector debe acortar el tiempo de decisión y facilitar la documentación de los casos difíciles, no complicarla.
Lista de funciones para la compra
Los compradores deberían preguntar por control de umbrales, registros exportables, contratos de API claros y compatibilidad con la repetición de un caso más adelante. También deberían comprobar si el producto procesa capturas de pantalla, imágenes sociales recomprimidas, recursos de marketing editados y familias recientes de generadores.
Igualmente importante es el encaje de integración. Si la herramienta no puede conectarse limpiamente con los sistemas donde se almacenan y revisan las evidencias, la organización acaba copiando las puntuaciones manualmente en las notas de los casos. Eso crea fricción, debilita las trazas de auditoría y hace que los revisores confíen menos en la herramienta con el tiempo.
Preguntas de compra que merece la pena hacer
- ¿Qué fuentes de imágenes incluye el benchmark del proveedor?
- ¿Con qué frecuencia se actualiza el modelo frente a nuevos generadores?
- ¿Puede el equipo definir umbrales distintos para colas distintas?
- ¿Qué evidencias se muestran además de una única puntuación de probabilidad?
- ¿Se pueden exportar los resultados a registros de moderación o confianza?
- ¿Cómo se comporta la herramienta con capturas de pantalla y archivos editados?
Por qué las pilas con una sola herramienta son arriesgadas
Un detector es más eficaz cuando trabaja junto a otras capas de evidencia. Las comprobaciones de procedencia, la búsqueda inversa, los metadatos, el historial del cargador y el criterio del revisor cubren modos de fallo que un clasificador por sí solo no puede cubrir. Por eso importan el ecosistema de Content Credentials y la especificación C2PA: permiten verificar el origen en vez de inferirlo solo a partir de los píxeles.
Depender de una sola herramienta también es arriesgado porque los proveedores pueden cambiar. El benchmark que te convenció de comprarla puede quedar obsoleto rápidamente. Si el equipo no tiene comprobaciones secundarias, la deriva del modelo se convierte en deuda operativa en lugar de un problema de monitorización manejable.
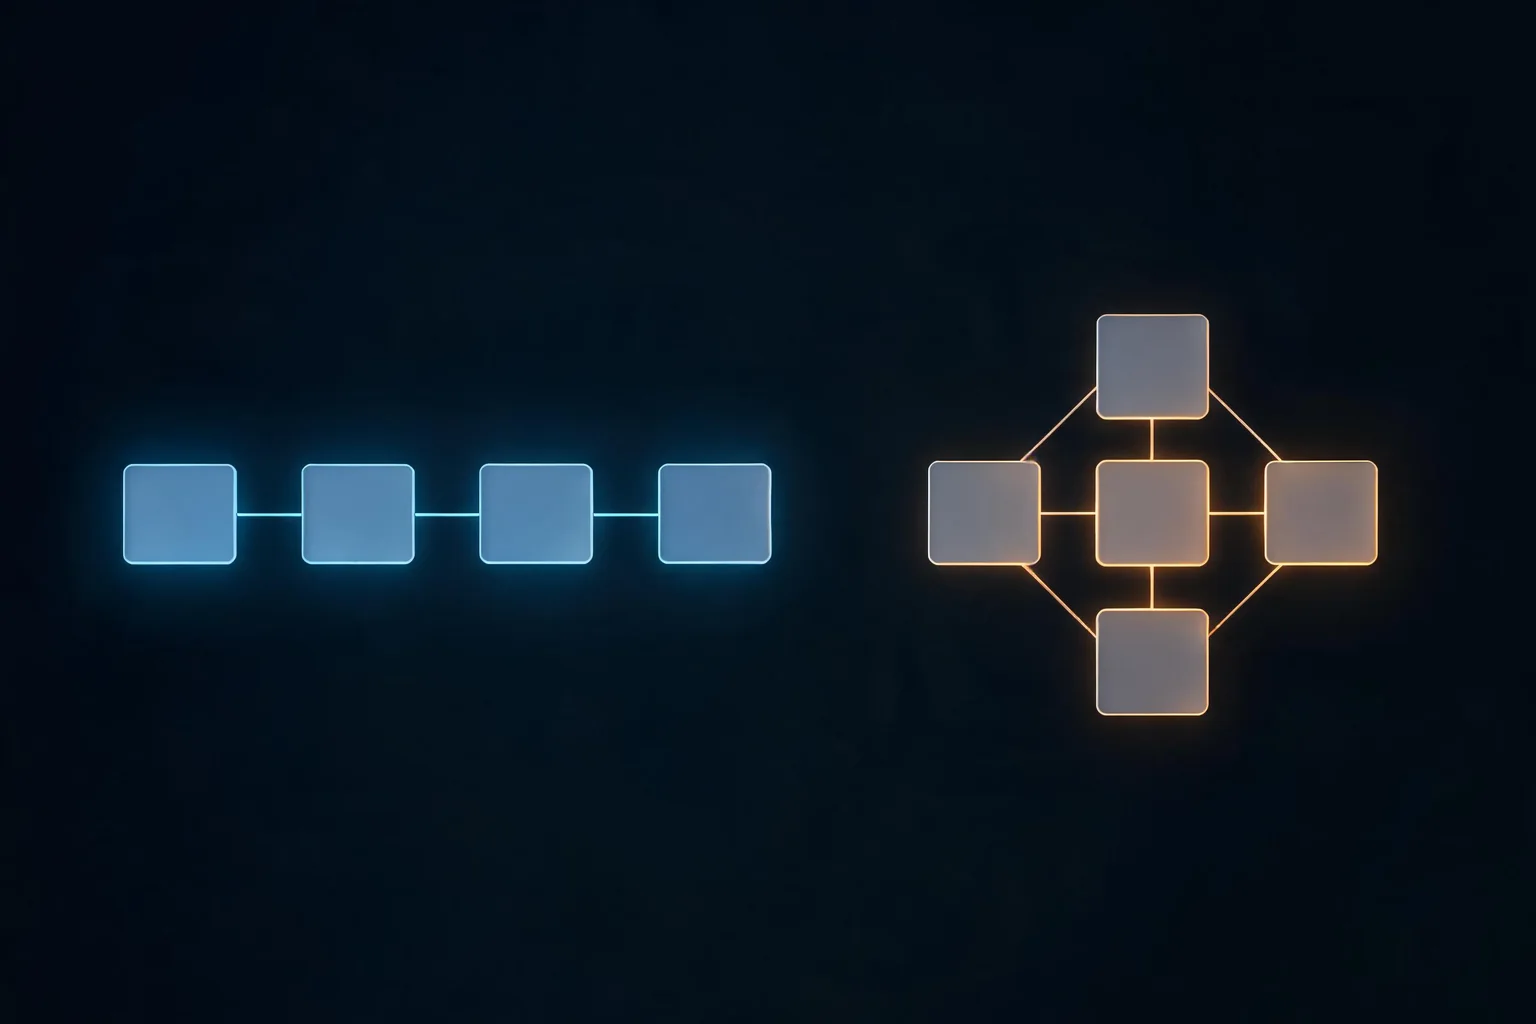
Los programas de revisión más resistentes tratan los detectores como un componente dentro de una cadena de evidencias. Este diseño facilita cambiar de proveedor, ajustar umbrales o añadir comprobaciones de procedencia más adelante sin volver a formar a toda la organización.
Cómo realizar una prueba realista
Haz las pruebas con una muestra representativa, no con una selección idealizada. Incluye fotos reales, imágenes editadas reales, imágenes recientes generadas por IA, capturas de pantalla y los tipos de imágenes que tu cola recibe con mayor frecuencia. Deja que los revisores reales usen el producto en modo paralelo para saber si el formato de la evidencia les ayuda o les confunde.
Registra qué cambió durante la prueba: tiempo en cola, coincidencia entre revisores, tasa de escalado, coste de los falsos positivos y si la salida mejoró las decisiones o simplemente añadió otro número. El NIST AI Risk Management Framework resulta útil porque trata la gobernanza y la monitorización como parte de la calidad del despliegue, no como papeleo añadido después.
Cuándo no comprar ningún detector todavía
Algunos equipos aún no necesitan un detector. Si la brecha real está en la política, las comprobaciones de procedencia, la validación de fuentes o la responsabilidad de los revisores, comprar un clasificador puede ocultar el problema de proceso más profundo. Un equipo pequeño suele obtener más valor de una ruta de escalado documentada y un flujo de comprobación de procedencia que de un modelo sofisticado sin un lugar operativo donde encajarlo.
Cómo se ve el éxito después de la compra
Un despliegue exitoso no solo reduce la cola pendiente. También debería mejorar la coherencia de los revisores, reducir la incertidumbre en casos repetibles y facilitar la documentación de apelaciones. Si la herramienta añade fricción, oculta evidencias o crea nuevos ciclos de discusión entre revisores, no es la mejor opción aunque el benchmark pareciera sólido.
Compra un detector cuando reduzca claramente el tiempo de decisión, mejore la coherencia y encaje en el rastro de evidencia que tus revisores realmente necesitan.
El mejor piloto corto termina con una respuesta poco espectacular: los revisores saben cuándo confiar en la puntuación, cuándo pedir más evidencia y cuándo dejar de fingir que existe certeza. Esa es una señal de compra más fuerte que una diapositiva de benchmark brillante. Para decisiones relacionadas, compara esta guía con AI Image Detector Accuracy Explained y How Teams Can Verify Image Authenticity in the AI Era.