Puntos clave
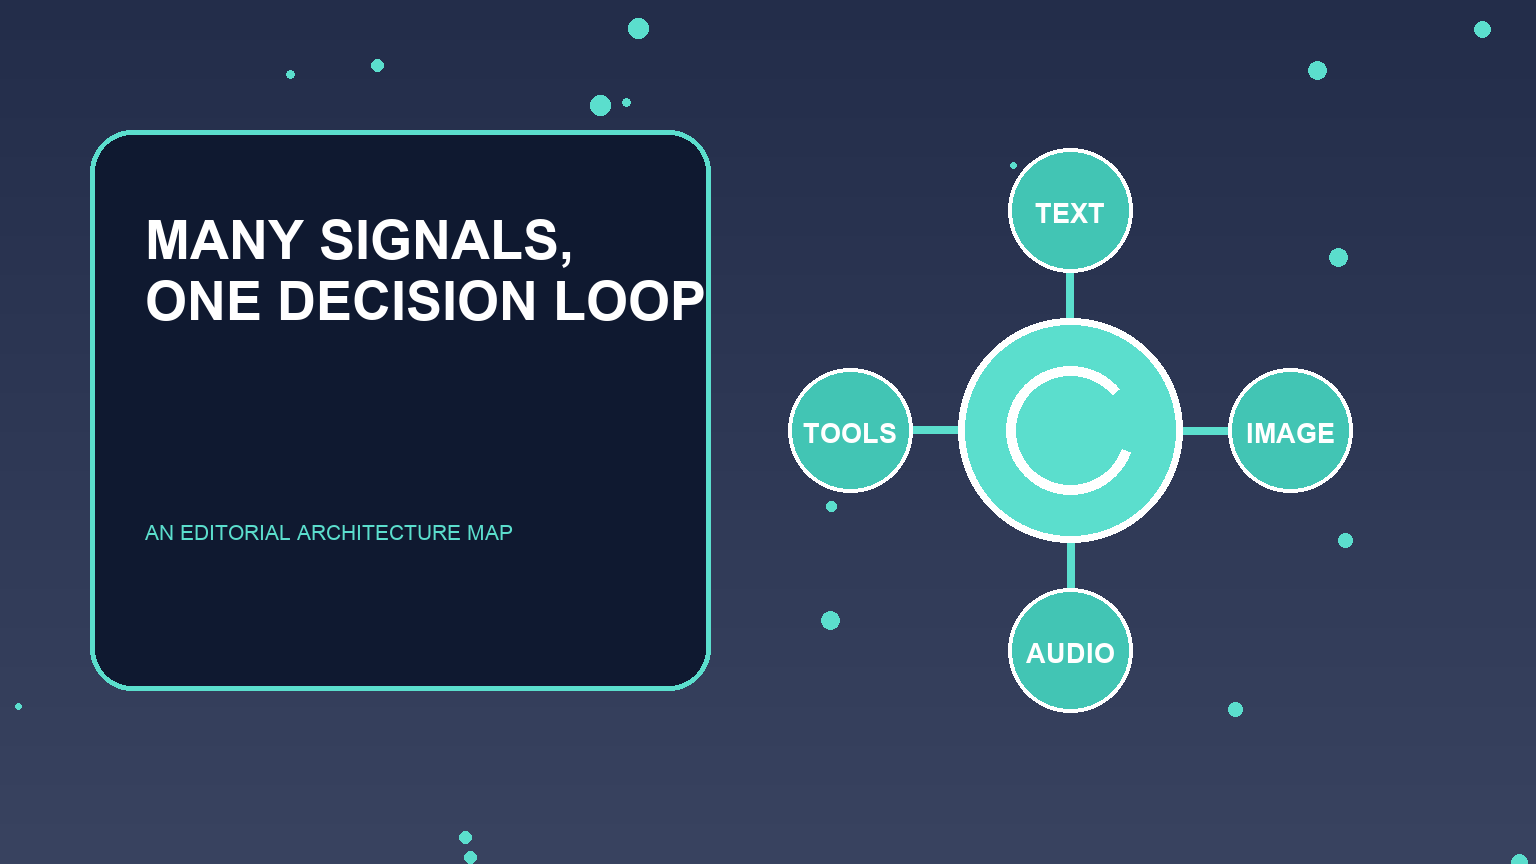
- Crear agentes de IA con modelos multimodales requiere algo más que añadir imágenes a un prompt. Un sistema fiable registra la fuente y la marca temporal de cada modalidad, convierte la percepción en observaciones estructuradas, evalúa la incertidumbre e impide que contenido multimedia no confiable autorice directamente acciones de herramientas.
Crear agentes de IA con modelos multimodales requiere algo más que añadir imágenes a un prompt. Un sistema fiable registra la fuente y la marca temporal de cada modalidad, convierte la percepción en observaciones estructuradas, evalúa la incertidumbre e impide que contenido multimedia no confiable autorice directamente acciones de herramientas.
Elegir las modalidades según la tarea
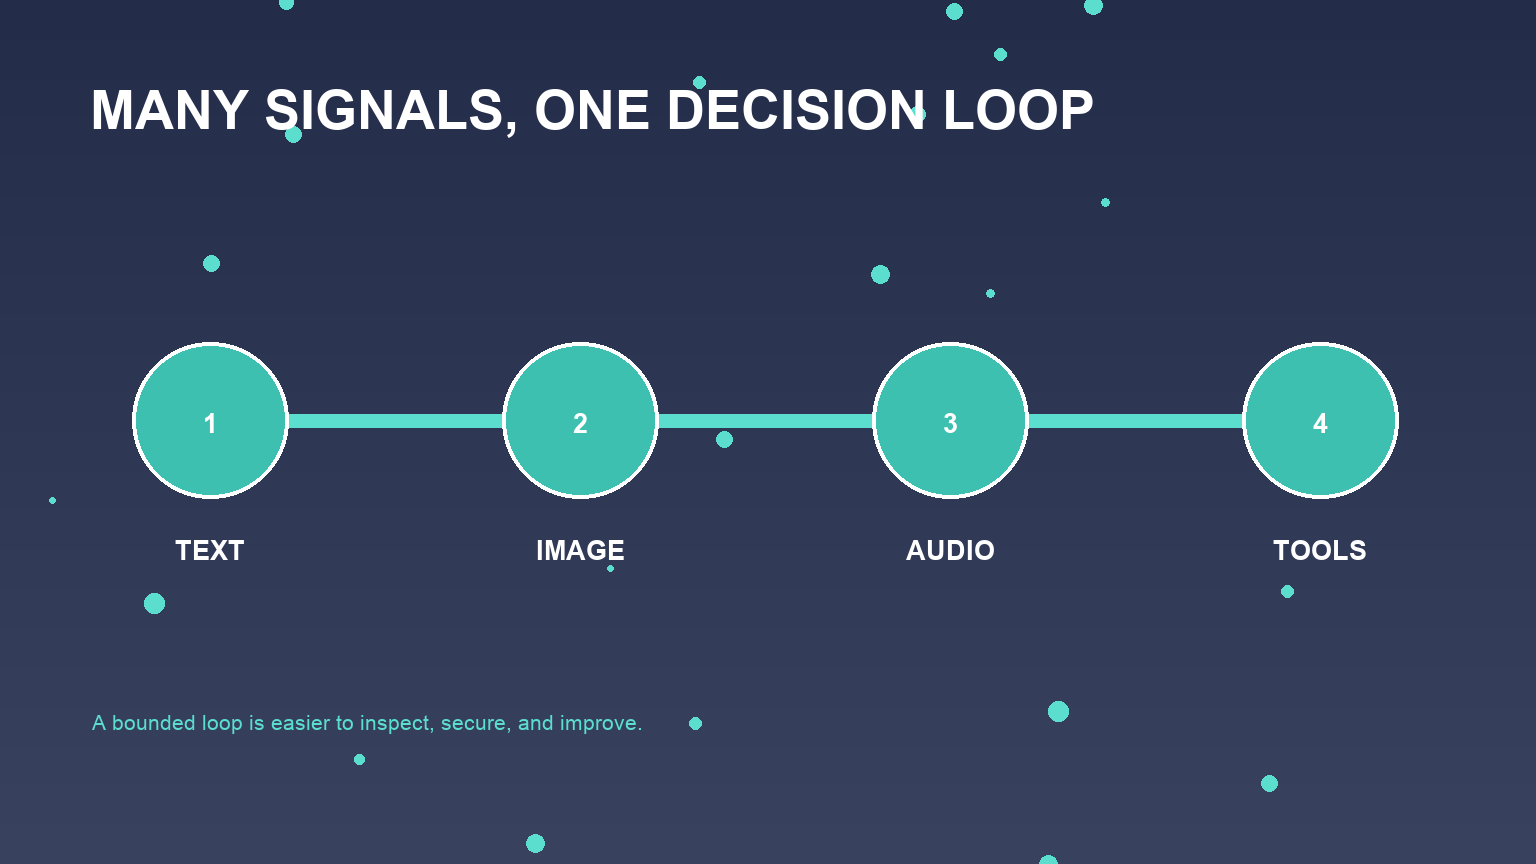
Empieza por la decisión que debe respaldar el agente. Las imágenes ayudan a interpretar estados espaciales o visuales; el audio, el habla y los sonidos del entorno; el vídeo, los cambios a lo largo del tiempo; y los documentos, la estructura y el texto. Añadir todas las modalidades aumenta los costos, la exposición de datos privados y los problemas de sincronización. Usa el conjunto mínimo que mejore una tarea medible.
Define qué puede inferir el modelo. Una captura de pantalla puede mostrar el estado visible de una interfaz, pero no demostrar quién es el titular de la cuenta. Una imagen de cámara puede sugerir qué objeto aparece, pero quizá no permita establecer su identidad, seguridad o intención. Las conclusiones de alto impacto necesitan sensores más sólidos, metadatos o confirmación humana.
Ingesta, sincronización y procedencia
Cada entrada debe incluir la fuente, la hora de captura, el tipo de contenido, sus dimensiones o duración, las transformaciones aplicadas y el alcance de acceso. Conserva el original cuando la política lo permita y guarda las miniaturas, transcripciones o fotogramas derivados como recursos separados. Los hashes y los identificadores permiten rastrear cada conclusión hasta las pruebas que la respaldan.
El tiempo importa. Una captura desactualizada puede contradecir una respuesta actual de la API. Si se muestrean pocos fotogramas de un vídeo, quizá no se capte un suceso. Las transcripciones de audio pueden perder información sobre quién habla o su tono. El agente debe hacer visibles estos límites y evitar combinar observaciones como si fueran simultáneas.
Convertir la percepción en observaciones estructuradas
No envíes una descripción visual sin límites directamente al ejecutor. Extrae observaciones tipadas, como etiquetas de controles detectadas, regiones delimitadas, segmentos de transcripción, intervalos de confianza y ambigüedades sin resolver. Después, aplica reglas deterministas antes de elegir una acción.
Vincula las acciones visuales al estado actual. En agentes de navegador o de escritorio, vuelve a observar la pantalla después de cada navegación y antes de hacer clic en algo importante. Las acciones basadas en coordenadas son frágiles cuando cambia el diseño. Si están disponibles, prefiere los datos semánticos de accesibilidad o las API del producto; usa los píxeles como pruebas complementarias, no como autoridad implícita.
Inyección de prompts multimodales y privacidad
Las imágenes pueden contener instrucciones, códigos QR, texto oculto o elementos engañosos de una interfaz. El audio puede incluir órdenes de una persona no confiable. Los documentos pueden ocultar texto malicioso en encabezados o fondos. Trata el contenido reconocido como datos con procedencia; no puede anular las políticas ni conceder acceso a herramientas.
Los datos multimodales suelen ser sensibles. Los rostros, las voces, las pantallas, las ubicaciones y los documentos pueden revelar información personal o confidencial. Limita la captura, recorta o redacta los datos antes de procesarlos con el modelo, restringe el tiempo de conservación y obtén el consentimiento correspondiente. No incluyas secretos ni zonas irrelevantes de la pantalla en el contexto.
Diseño de verificación y alternativas de respaldo
Usa comprobaciones acordes con el nivel de riesgo. El OCR puede verificar una etiqueta visible; una API, confirmar el estado de una transacción; y un segundo fotograma, mostrar que un cambio se mantuvo. Que varias modalidades coincidan es útil, pero no constituye una prueba si todas proceden de la misma fuente manipulada. Ante casos ambiguos o críticos para la seguridad, detente y consulta a una persona.
La alternativa de respaldo debe mantener la función con menor autonomía. Si falla la visión, solicita una imagen más clara o cambia a una entrada estructurada. Si la transcripción de audio es incierta, muéstrala para que alguien la confirme. Si un vídeo supera los límites, selecciona segmentos aprobados por el usuario en lugar de descartar contenido sin avisar.
Evaluar fallos multimodales realistas
Crea un conjunto de datos con desenfoque, reflejos, oclusiones, acentos, ruido de fondo, cambios de diseño, fotogramas desactualizados, descripciones contradictorias, texto malicioso y metadatos ausentes. Evalúa la percepción por separado de la decisión y la ejecución para identificar dónde empiezan los errores. Mide también la latencia, el ancho de banda, los costos y el tratamiento de la privacidad.
Vuelve a reproducir trazas completas después de cambiar el modelo o el preprocesamiento. Supervisa las tasas de error de cada modalidad y el tiempo que las personas dedican a corregirlos. Los agentes multimodales pueden interactuar con entornos más ricos, pero para que funcionen de forma segura hacen falta procedencia, acciones acotadas y verificación; ver y oír no significa comprender.
Hoja de trabajo de implementación
Crea una ficha de datos para cada modalidad de entrada con la fuente, la hora de captura, las transformaciones, la calidad prevista, los datos sensibles, el tiempo de conservación y los puntos ciegos conocidos. Evalúa la percepción por separado de la política de acciones. Incluye casos con capturas desactualizadas, texto oculto, audio ruidoso, fotogramas ausentes, cambios de diseño y estados de API contradictorios. Exige que el agente cite el recurso que respalda cada observación y pida aclaraciones si su confianza es insuficiente. Comprueba si todas las modalidades capturadas son necesarias: eliminar una entrada puede mejorar la privacidad, la latencia y la fiabilidad.
Preguntas frecuentes
¿Qué es un agente de IA multimodal?
Es un agente que utiliza dos o más modalidades de entrada o salida —como texto, imágenes, audio, vídeo o datos de sensores— mientras planifica y usa herramientas.
¿Puede una imagen dar instrucciones a un agente para que actúe?
El texto que aparece en una imagen debe tratarse como información no confiable. Puede servir para formular una propuesta, pero no puede anular las políticas, conceder permisos ni autorizar una llamada importante a una herramienta.
¿Cómo deben almacenarse las pruebas multimodales?
Registra la fuente, la hora de captura, las transformaciones, el alcance de acceso, los identificadores de los recursos y los hashes cuando corresponda, para que las observaciones se puedan rastrear.
¿Cómo se evalúa un agente multimodal?
Evalúa por separado la percepción, la decisión y la ejecución con casos realistas de desenfoque, ruido, oclusiones, cambios de diseño, pruebas desactualizadas, modalidades contradictorias e inyección de prompts.