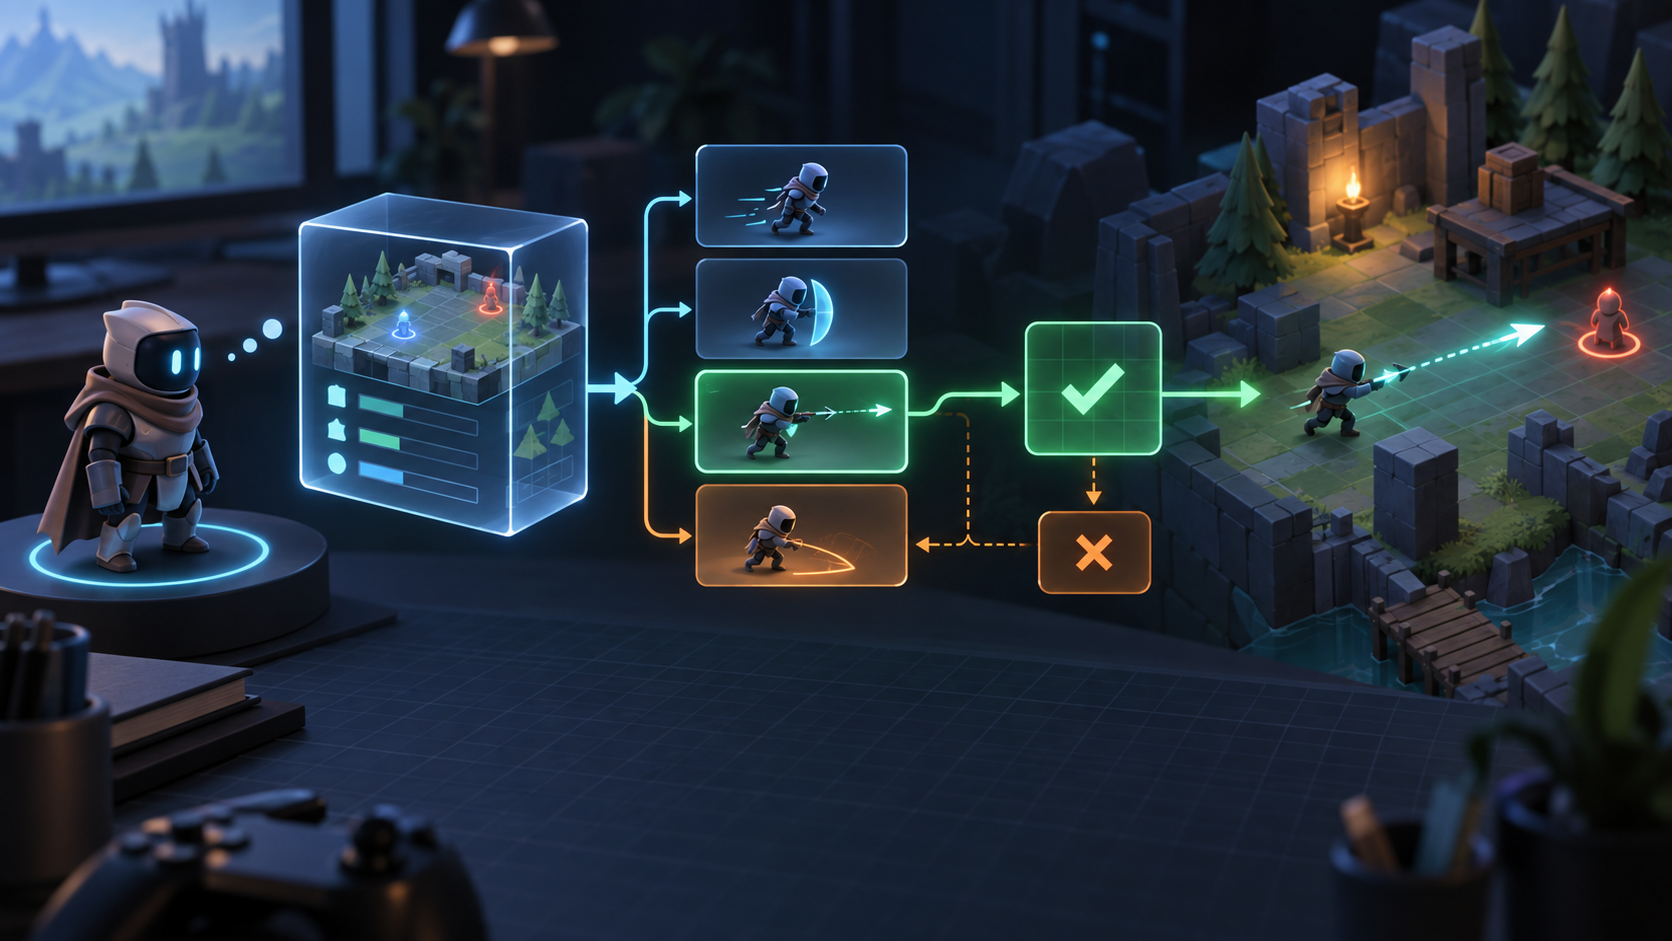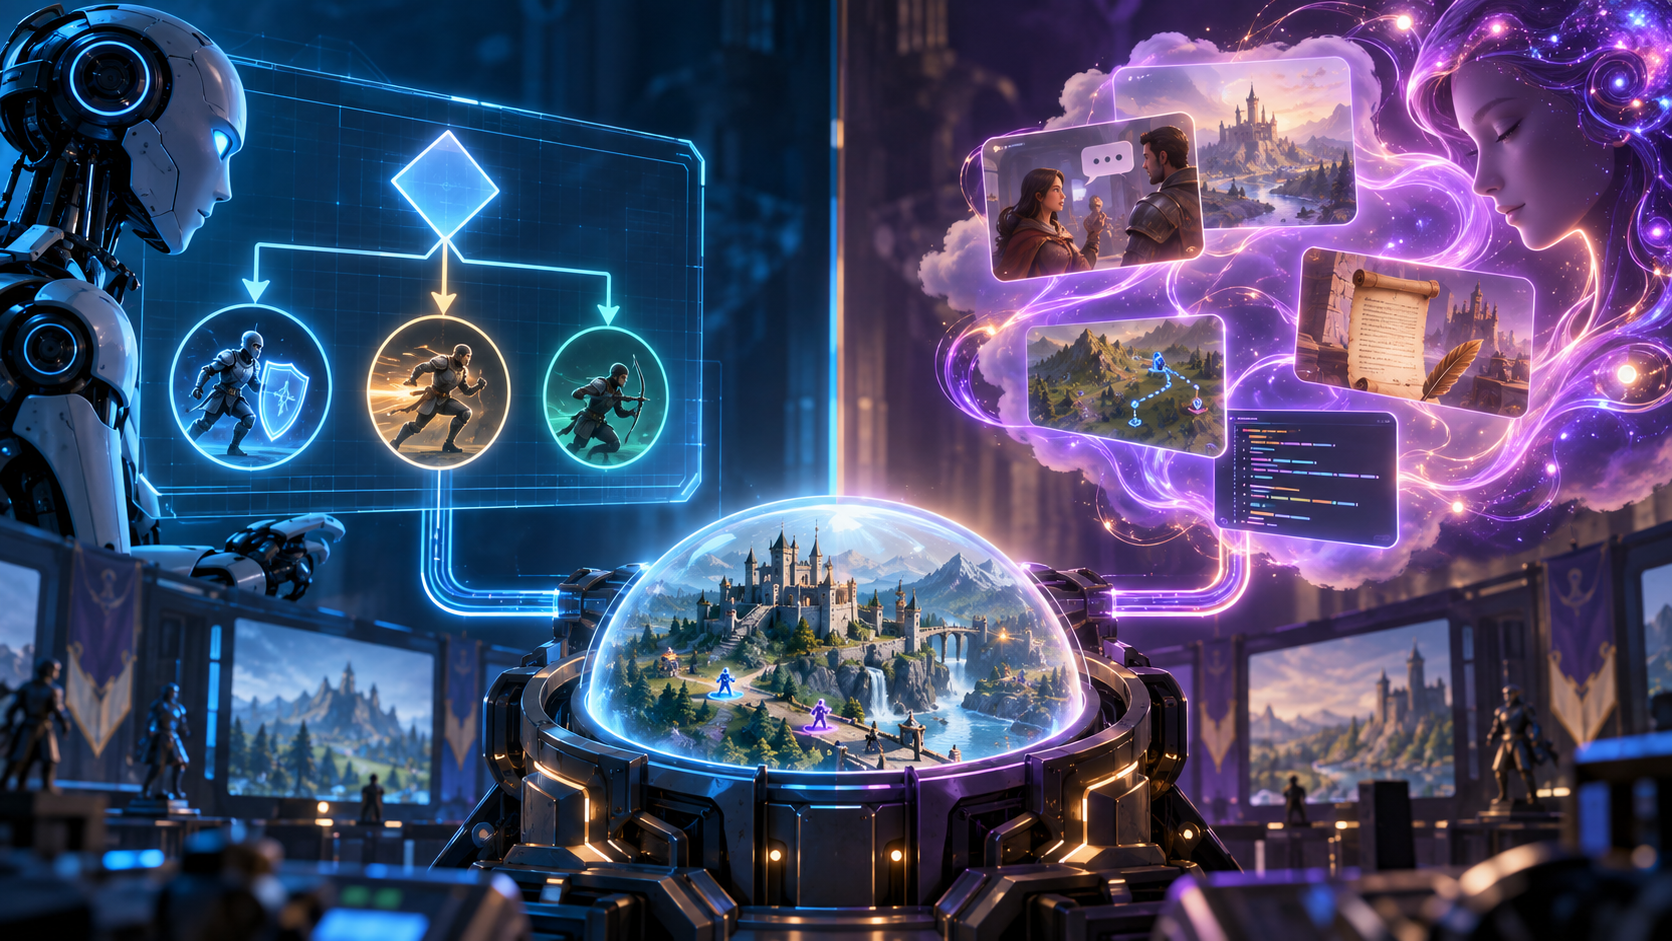
JEV y LLMs resuelven diferentes problemas en un juego. Un LLM es un generador e intérprete de uso general para lenguaje, planos, código, diálogo e instrucciones abiertas. JEV es una capacidad de decisión limitada: evalúa una proyección del estado del juego frente a preguntas escritas y devuelve un resultado restringido como un Choice, Score o un juicio de sí o no. La mejor arquitectura suele utilizar ambos.
La respuesta corta
Utilice JEV cuando el juego conozca las opciones legales y necesite un juicio escrito sobre ellas. Utilice un LLM para diálogo, narrativa, explicación, código, generación abierta o planificación más extensa. Ninguno de los dos debería poseer reglas de juego autorizadas; el motor valida y ejecuta los resultados.
| Capacidad | JEV | LLM |
|---|---|---|
| 1__ | Salida | Escrito Choice, Score, o juicio acotado |
| Texto, código, planes, diálogo o estructurado salida | Mejor fit | Evaluación del estado y selección de acción candidata |
| Conversación, narrativa, planificación y generación | Acción espacio | Candidatos cerrados y validados |
| Abierto posibilidades | Juego rol | Capa de decisión o táctica |
Diálogo, contenidos y alto nivel planificación
Qué JEV devuelvePúblico JEV los materiales describen primitivas escritas como Choice, Score, y Noul
. Un Choice selecciona un elemento de un conjunto definido. Un Score clasifica a los candidatos. Un Noul responde a una pregunta limitada de sí o no. El juego define la pregunta y el resultado permitido en lugar de pedir prosa sin restricciones.
En qué son buenos los LLMs
Los
LLMs pueden escribir NPC diálogos, resumir el historial de misiones, generar resúmenes de misiones, explicar un diseño Choice, transformar el lenguaje natural en un borrador de misión o proponer un plan a largo plazo. Cualquier plan aún debe convertirse en comandos aprobados y superar el límite de validación del juego.
¿Por qué no utilizar un LLM para cada tick?
- El control por tick hace que una interfaz de lenguaje general sea responsable de la parte más sensible a los plazos del ciclo del juego. La salida puede ser demasiado lenta, detallada o abierta, y el comportamiento se vuelve más difícil de reproducir. Las comprobaciones de dirección, colisión, animación y seguridad de bajo nivel normalmente son deterministas. Activa una decisión táctica cuando aparece una amenaza, se completa una acción o cambia un objetivo.
- Una arquitectura híbrida JEV y LLM
- El LLM maneja el diálogo, la interpretación de misiones o un alto nivel. plan.
- El código del juego traduce ese resultado en estado compacto y cerrado Legal Actions.
- JEV elige, Scores, o cierra la táctica decisión.
Un árbol de comportamiento, sistema de habilidades o ejecutor realiza la acción.
- Estado de registros de telemetría, latencia, validez y resultado.
- Lista de verificación de decisiones
- Conocido Choice, Score, o pregunta de sí o no: JEV puede fit.
- Diálogo, prosa, código o plan abierto: un LLM puede fit.
¿Puede el juego validar el resultado antes de la ejecución?
¿Hay una fecha límite? fallback y estado reproducible?
Comparar por capa, no por exageración
- La comparación más útil pregunta qué capa del juego posee cada sistema. La percepción y el estado de autoridad pertenecen al motor. La selección táctica puede utilizar un modelo de decisión acotado. El diálogo y la narrativa pueden utilizar un LLM. La navegación, la animación, la física y la replicación deben seguir siendo deterministas. Esta vista en capas evita el falso Choice de poner un modelo a cargo de todo el NPC.Tres patrones híbridos
- LLM a JEV: el LLM interpreta la solicitud de un jugador o el objetivo de una misión, luego el código del juego lo convierte en una pregunta táctica limitada para JEV.
- JEV a LLM: JEV selecciona una situación u objetivo que merece explicación, mientras que el LLM escribe un diálogo o una misión update.
Especialistas paralelos:
JEV hace un tiempo urgente Choice mientras que un LLM prepara diálogo, memoria o contenido sin bloqueo para un momento posterior.
- En los tres patrones, el juego posee el contrato de traspaso. Un plan en lenguaje natural no es un comando ejecutable y un Choice escrito no es un permiso para omitir la validación.Modos de falla para diseñar
- Salida abierta: convertirlo en un conjunto de comandos cerrado antes ejecución.
- Estado obsoleto: adjunte una versión y rechace los resultados que ya no describan el world.
- Respuesta lenta: preservar la intención actual o cambiar a un local política.
- Deriva del mensaje: mantener los esquemas de preguntas versionados y rejugable.
Confusión de roles:
documenta si un componente elige, explica o ejecuta.
Matriz de selecciónElija JEV cuando se conozcan los candidatos, se debe escribir la decisión y el juego puede evaluar la validez. Elija un LLM cuando el idioma o la generación abierta sea el producto de la llamada. No elija ninguna de las dos opciones para una regla determinista que ya es fácil de expresar en código. La mejor arquitectura de IA a menudo reduce la responsabilidad del modelo hasta que su resultado pueda probarse como cualquier otro subsistema.Para la implementación, continúe con JEV API uso. Para la arquitectura NPC, lea JEV NPC. Para un contexto más amplio, consulte