Points clés
- Créer des agents d’IA avec des modèles multimodaux ne consiste pas seulement à ajouter des images à un prompt. Un système fiable suit la source et l’horodatage de chaque modalité, transforme la perception en observations structurées, évalue l’incertitude et empêche les médias non fiables d’autoriser directement des actions d’outils.
Créer des agents d’IA avec des modèles multimodaux ne consiste pas seulement à ajouter des images à un prompt. Un système fiable suit la source et l’horodatage de chaque modalité, transforme la perception en observations structurées, évalue l’incertitude et empêche les médias non fiables d’autoriser directement des actions d’outils.
Choisir les modalités en fonction de la tâche
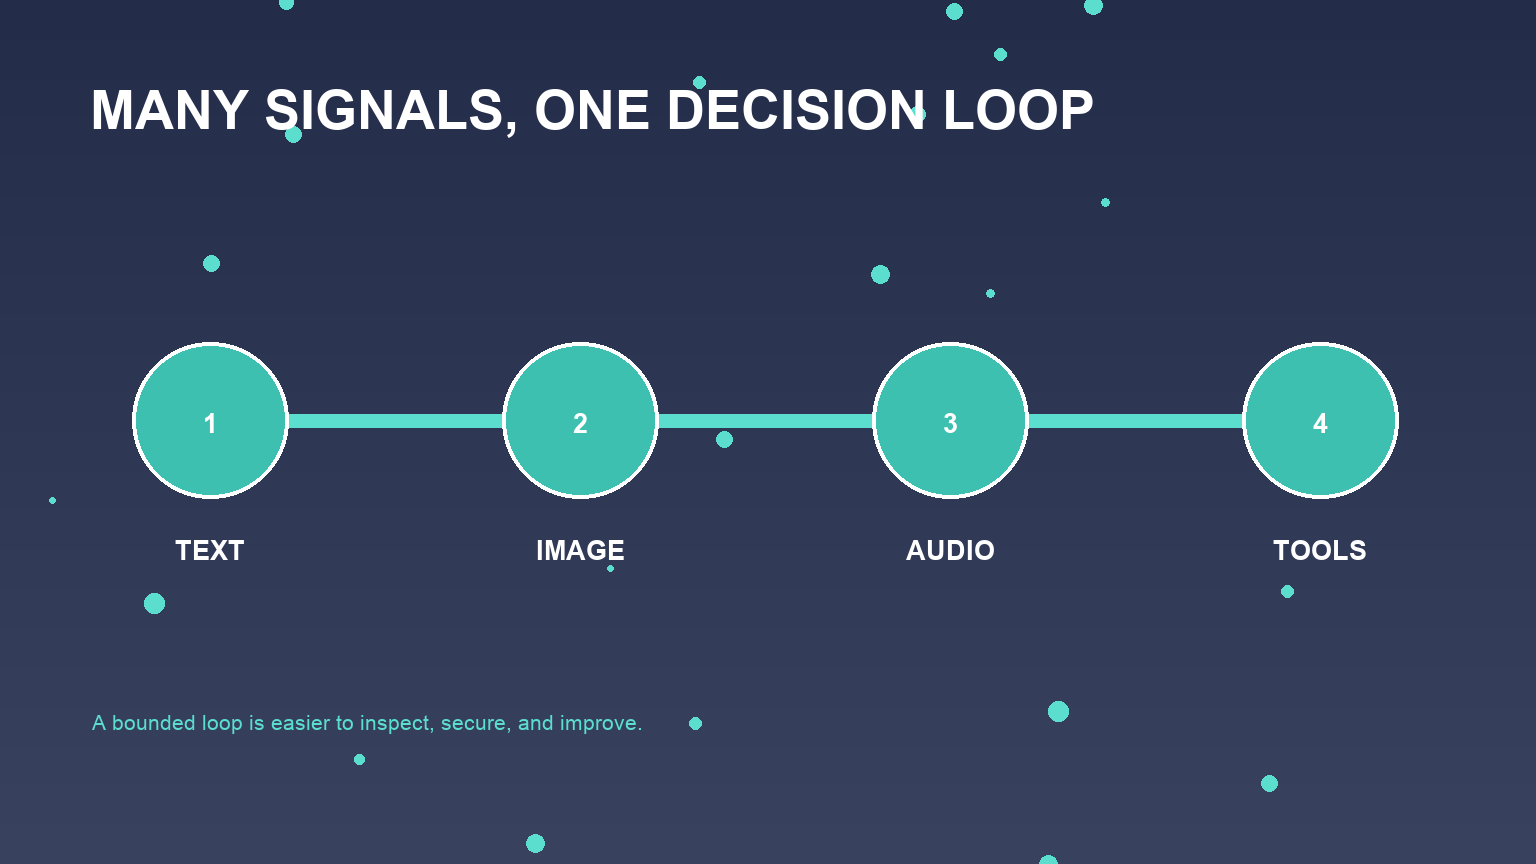
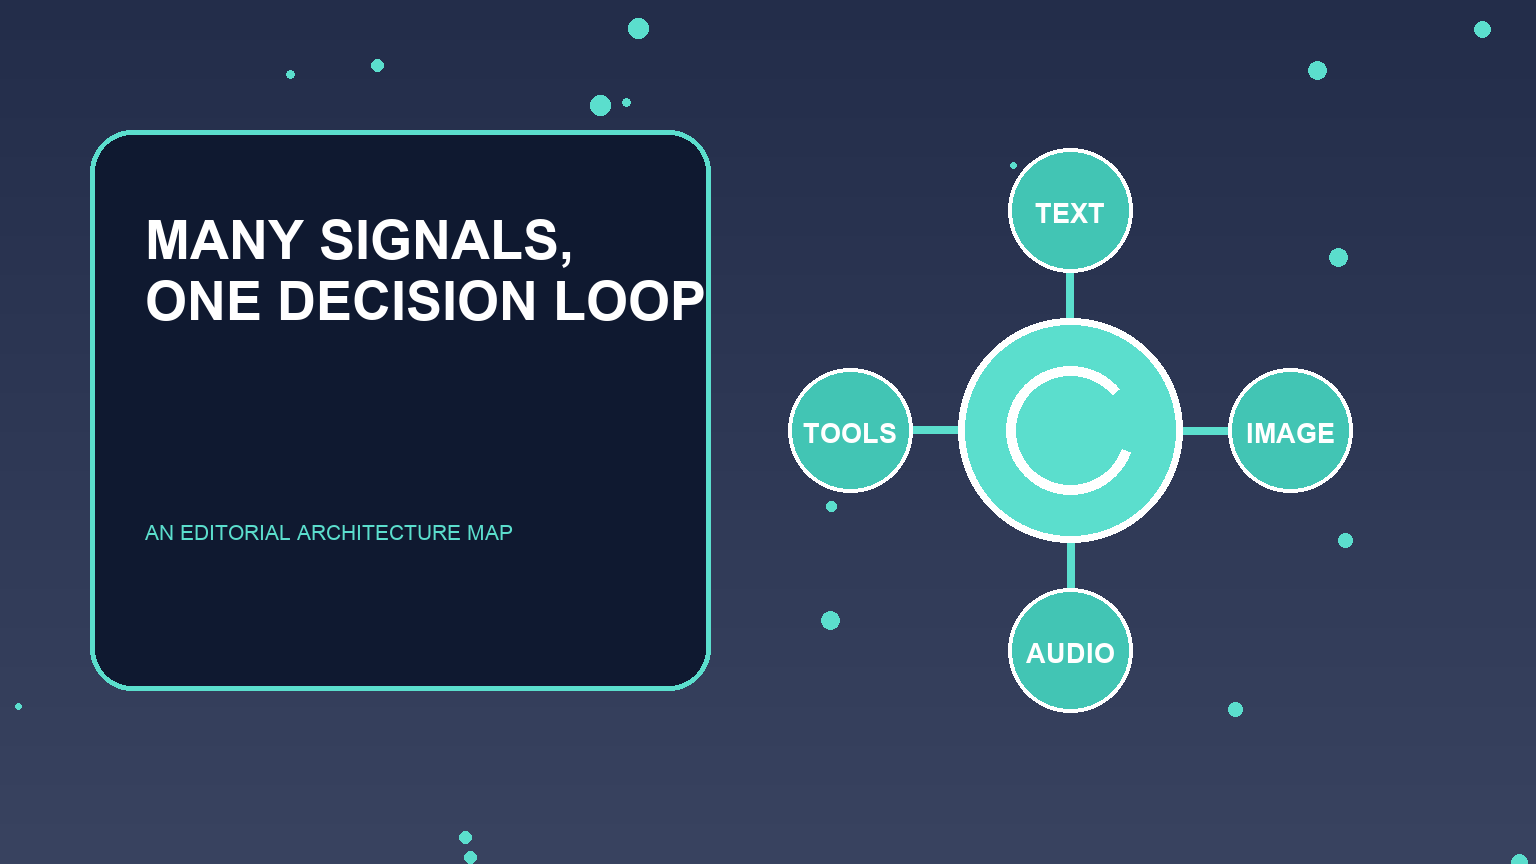
Commencez par la décision que l’agent doit aider à prendre. Les images renseignent sur l’état spatial ou visuel, l’audio sur la parole et les événements acoustiques, la vidéo sur les changements au fil du temps, et les documents sur la mise en page et le texte. Ajouter toutes les modalités augmente les coûts, l’exposition des données personnelles et les problèmes de synchronisation. Utilisez l’ensemble minimal qui améliore une tâche mesurable.
Définissez ce que le modèle peut déduire. Une capture d’écran peut montrer l’état visible d’une interface, mais pas prouver qui possède le compte. Une image de caméra peut suggérer la présence d’un objet, sans établir son identité, son innocuité ou son intention. Les conclusions à fort impact nécessitent des capteurs plus fiables, des métadonnées ou une confirmation humaine.
Ingestion, horodatage et provenance
Chaque entrée doit préciser la source, l’heure de capture, le type de contenu, ses dimensions ou sa durée, les transformations appliquées et les droits d’accès. Conservez l’original lorsque les règles le permettent et stockez séparément les miniatures, transcriptions ou images dérivées. Les empreintes numériques et les identifiants permettent de rattacher une conclusion aux éléments qui l’étayent.
Le temps compte. Une capture d’écran obsolète peut contredire une réponse actuelle de l’API. Un échantillonnage trop espacé des images vidéo peut manquer un événement. Une transcription audio peut perdre des informations sur l’identité du locuteur ou son ton. L’agent doit rendre ces limites visibles et éviter de fusionner des observations comme si elles étaient simultanées.
Transformer la perception en observations structurées
Ne transmettez pas directement une description visuelle sans limites au composant d’exécution. Extrayez des observations typées, telles que les libellés de contrôles détectés, les régions délimitées, les segments de transcription, les intervalles de confiance et les ambiguïtés non résolues. Appliquez ensuite des règles déterministes avant de choisir une action.
Ancrez les actions visuelles dans l’état actuel. Pour les agents de navigateur ou de bureau, observez de nouveau l’interface après chaque navigation et avant un clic important. Les actions fondées sur des coordonnées deviennent fragiles lorsque la mise en page change. Privilégiez les données d’accessibilité sémantique ou les API du produit lorsqu’elles existent ; utilisez les pixels comme éléments complémentaires, et non comme autorité implicite.
Injection de prompt multimodale et confidentialité
Les images peuvent contenir des instructions, des codes QR, du texte caché ou des éléments d’interface trompeurs. L’audio peut contenir des commandes prononcées par une personne non fiable. Les documents peuvent dissimuler du texte malveillant dans leurs en-têtes ou leur arrière-plan. Traitez le contenu reconnu comme une donnée avec sa provenance. Il ne peut ni remplacer les règles ni accorder l’accès aux outils.
Les données multimodales sont souvent sensibles. Les visages, les voix, les écrans, les lieux et les documents peuvent révéler des informations personnelles ou confidentielles. Limitez la capture, recadrez ou caviardez les données avant leur traitement par le modèle, limitez leur durée de conservation et obtenez le consentement approprié. N’incluez dans le contexte ni secrets ni zones d’écran sans rapport avec la tâche.
Conception des vérifications et des solutions de repli
Effectuez des vérifications adaptées au risque. L’OCR peut confirmer un libellé visible ; une API, l’état d’une transaction ; une deuxième image, la persistance d’une modification. La concordance entre modalités est utile, mais ne constitue pas une preuve si elles proviennent de la même source manipulée. En cas d’ambiguïté ou de risque pour la sécurité, arrêtez-vous et demandez à une personne.
Une solution de repli doit préserver la fonction avec moins d’autonomie. Si la vision échoue, demandez une image plus nette ou passez à une entrée structurée. Si la transcription audio est incertaine, affichez-la pour confirmation. Si une vidéo dépasse les limites, sélectionnez des segments approuvés par l’utilisateur au lieu de supprimer du contenu sans le signaler.
Évaluer des défaillances multimodales réalistes
Créez un jeu de données comprenant du flou, des reflets, des occultations, des accents, du bruit de fond, des changements de mise en page, des images obsolètes, des légendes contradictoires, du texte injecté et des métadonnées manquantes. Évaluez séparément la perception, la décision et l’exécution pour identifier l’origine des erreurs. Mesurez aussi la latence, la bande passante, les coûts et la protection de la vie privée.
Rejouez les traces complètes après chaque changement de modèle ou de prétraitement. Surveillez le taux d’échec de chaque modalité ainsi que le temps consacré aux corrections humaines. Les agents multimodaux peuvent interagir avec des environnements plus riches, mais leur sécurité dépend de la provenance, d’actions limitées et de vérifications, et non de l’idée que voir et entendre signifie comprendre.
Fiche de mise en œuvre
Créez pour chaque entrée une fiche indiquant sa source, l’heure de capture, les transformations, la qualité attendue, les données sensibles, la durée de conservation et les angles morts connus. Testez la perception séparément de la politique d’action. Ajoutez des cas comprenant des captures d’écran obsolètes, du texte caché, un audio bruité, des images manquantes, des changements de mise en page et des états d’API contradictoires. Demandez à l’agent de citer l’élément qui étaye chaque observation et de solliciter des précisions lorsque son niveau de confiance est insuffisant. Vérifiez si chaque modalité capturée est nécessaire : en supprimer une peut améliorer la confidentialité, la latence et la fiabilité.
FAQ
Qu’est-ce qu’un agent d’IA multimodal ?
C’est un agent qui utilise au moins deux modalités d’entrée ou de sortie — par exemple du texte, des images, de l’audio, de la vidéo ou des données de capteurs — pour planifier et utiliser des outils.
Une image peut-elle ordonner à un agent d’agir ?
Le texte présent dans une image doit être traité comme une donnée non fiable. Il peut éclairer une proposition, mais ne peut ni remplacer les règles, ni accorder une autorisation, ni autoriser un appel d’outil ayant des conséquences importantes.
Comment conserver les éléments de preuve multimodaux ?
Suivez la source, l’heure de capture, les transformations, les droits d’accès, les identifiants des éléments et, le cas échéant, leurs empreintes numériques afin que les observations restent traçables.
Comment tester un agent multimodal ?
Testez séparément la perception, la décision et l’exécution avec des cas réalistes de flou, de bruit, d’occultation, de changement de mise en page, d’éléments obsolètes, de modalités contradictoires et d’injection de prompt.